
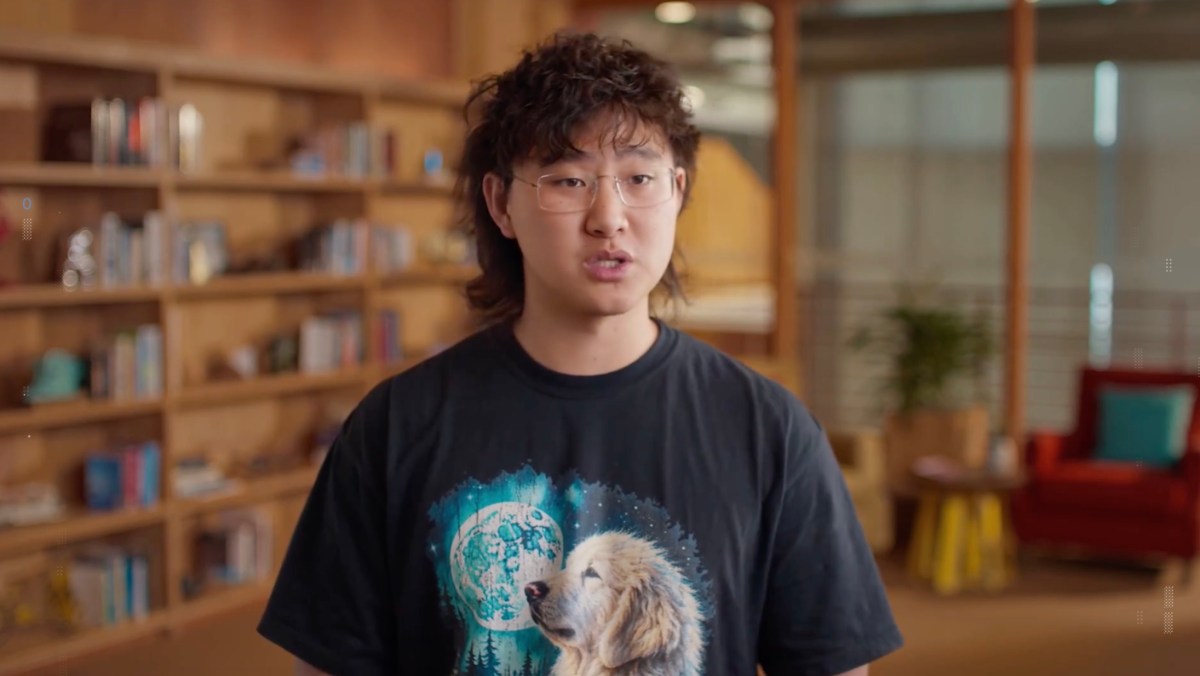
أصدر مختبر الذكاء الفائق في شركة ميتا نموذجي Muse Wonder وMuse Wonder Full يوم الإثنين الماضي، في أول محاولة للشركة لدخول مجال النماذج الرائدة منذ إعادة هيكلة جهود الذكاء الاصطناعي في أغسطس الماضي بقيادة ألكسندر وانغ.
قدرات متقدمة وأداء معياري مرتفع
تتميز النماذج الجديدة بحجم أكبر وقدرات أعلى مقارنة بنموذج Muse Spark الخفيف، حيث حققت نتائج متفوقة في المهام المعقدة مثل البرمجة. أظهرت الاختبارات الداخلية حصولها على درجات معيارية مماثلة لنماذج Fable 5.1 وGPT-6 Astra.
وصفت الشركة هذا الإطلاق بأنه خطوة نحو تحقيق الذكاء الفائق الشخصي، مع التركيز على تشغيل وكيل Muse عبر هذه التقنيات الحديثة. تهدف هذه النماذج إلى تقديم أداء عملي يتجاوز التجارب المخبرية التقليدية.
الذاكرة النشطة وتفوق في الاحتفاظ بالمعلومات
ركز المطورون على قدرة النماذج على الاحتفاظ بالمعلومات تحت مسمى الذاكرة النشطة، وهو ما أكدته الباحثة كافيا كوبارابو كجزء من جهود ضمان تذكر البيانات المهمة لفترات طويلة. تفوق نموذج Muse Wonder في اختبار MemoryBench على منافسيه من نماذج Fable وOpus وAstra.
يمثل هذا الأداء تقدماً تقنياً في معالجة مشكلات النسيان التي تعاني منها الأنظمة السابقة. وتعتمد الكفاءة الجديدة على بنية تدريب مصممة خصيصاً لتعزيز الاستدعاء الدقيق للمحتوى.
التسعير التجاري وتوفر النسخ الحصرية
تبلغ تكلفة استخدام Wonder عبر واجهة برمجة التطبيقات 4 دولارات لكل مليون رمز إدخال، بينما تصل تكلفة المخرجات إلى 20 دولاراً للمليون الواحد. يتوفر نموذج Wonder Full حصرياً لمشتركي خدمة Muse Code ولن يُطرح عبر واجهة برمجة التطبيقات العامة.
تُستخدم هذه النماذج الجديدة بشكل مباشر لتشغيل وكيل Muse ضمن المنظومة التقنية للشركة. ويأتي التمييز بين النسختين لتنظيم الوصول وفق فئات المستخدمين واحتياجاتهم البرمجية.
بنية تحتية جديدة في أوهايو
جرت عمليات تدريب النماذج في مركز بيانات بروميثيوس التابع لميتا والواقع في وسط ولاية أوهايو. بدأ هذا المركز الضخم عمله في وقت سابق من العام الحالي لدعم المشاريع الحسابية الكثيفة.
يعد هذا الإصدار الأول من نوعه للنماذج الرائدة بعد التغييرات الهيكلية التي شهدها قسم الذكاء الاصطناعي صيف العام الفائت. ويعتمد الاعتماد الكلي على البنية التحتية المحلية في تسريع وتيرة التطوير التقني.
التعليقات 0
كن أول من يعلق على هذا الخبر